 little goat
Jev: o que é a IA da TypeSafe e como ela funciona
Atualizado em
O Jev, da TypeSafe AI, devolve decisões tipadas com probabilidades em vez de texto. Veja como funciona, um exemplo prático e o que testar antes de integrar.
O Jev é um modelo de IA da TypeSafe AI que, em vez de escrever texto, toma decisões que um programa consegue usar direto. Você envia um contexto e perguntas cujas respostas possíveis já estão definidas, e o modelo devolve valores estruturados. Numa pergunta de múltipla escolha, por exemplo, a resposta traz a opção escolhida e a probabilidade de cada alternativa. Um uso típico é ler a mensagem de um cliente e decidir qual equipe deve atendê-la.
A TypeSafe anunciou o Jev em 15 de setembro de 2026 como o primeiro modelo da família que ela chama de System One Models, pensada para automação e não para conversa. No lançamento, o acesso era antecipado. Este artigo explica a proposta e o que ela muda para quem desenvolve software; a Little Goat não usou o modelo em produção. Fonte: anúncio da TypeSafe.
O Jev em resumo
- Empresa: TypeSafe AI.
- Categoria: System One Model, feito para decisões estruturadas, não para gerar texto.
- Entrada: um contexto, chamado de
state, e perguntas tipadas. - Saída: valores estruturados; nas perguntas Choice e Score, com a probabilidade de cada opção ou nível.
- Disponibilidade no lançamento: acesso antecipado pela plataforma da TypeSafe.
Como o Jev funciona
A documentação descreve três tipos de pergunta, que a TypeSafe chama de primitivas:
- Choice escolhe uma opção de uma lista.
- Score dá uma nota ao contexto segundo uma escala de critérios.
- Noul diz se uma afirmação é verdadeira, com um valor entre 0 e 1.
Uma mesma chamada pode levar várias perguntas. Segundo a TypeSafe, cada uma é avaliada em paralelo e isoladamente sobre o mesmo contexto, e acrescentar perguntas quase não muda o tempo de resposta. A recomendação é quebrar julgamentos amplos em perguntas específicas e juntar os resultados com lógica no próprio código. Fonte: introdução técnica.
Isso muda o trabalho de integração. Em vez de pedir ao modelo uma análise geral de um atendimento, a equipe faz perguntas separadas sobre assunto, urgência e informação que falta. Cada resposta alimenta uma regra explícita, que pode ser revisada sem reescrever o prompt inteiro.
Qual a diferença entre o Jev e um modelo de chat?
Um modelo de chat devolve texto, e o programa precisa interpretar esse texto para saber o que fazer. O Jev abre mão de gerar texto: as saídas possíveis e a estrutura da resposta ficam definidas antes da chamada. Fonte: anúncio da TypeSafe.
A vantagem é que a resposta já chega no formato que o código espera. Em troca, o modelo não serve para redigir uma resposta ao cliente, resumir um documento ou conversar com alguém.
Exemplo: encaminhar um chamado de suporte
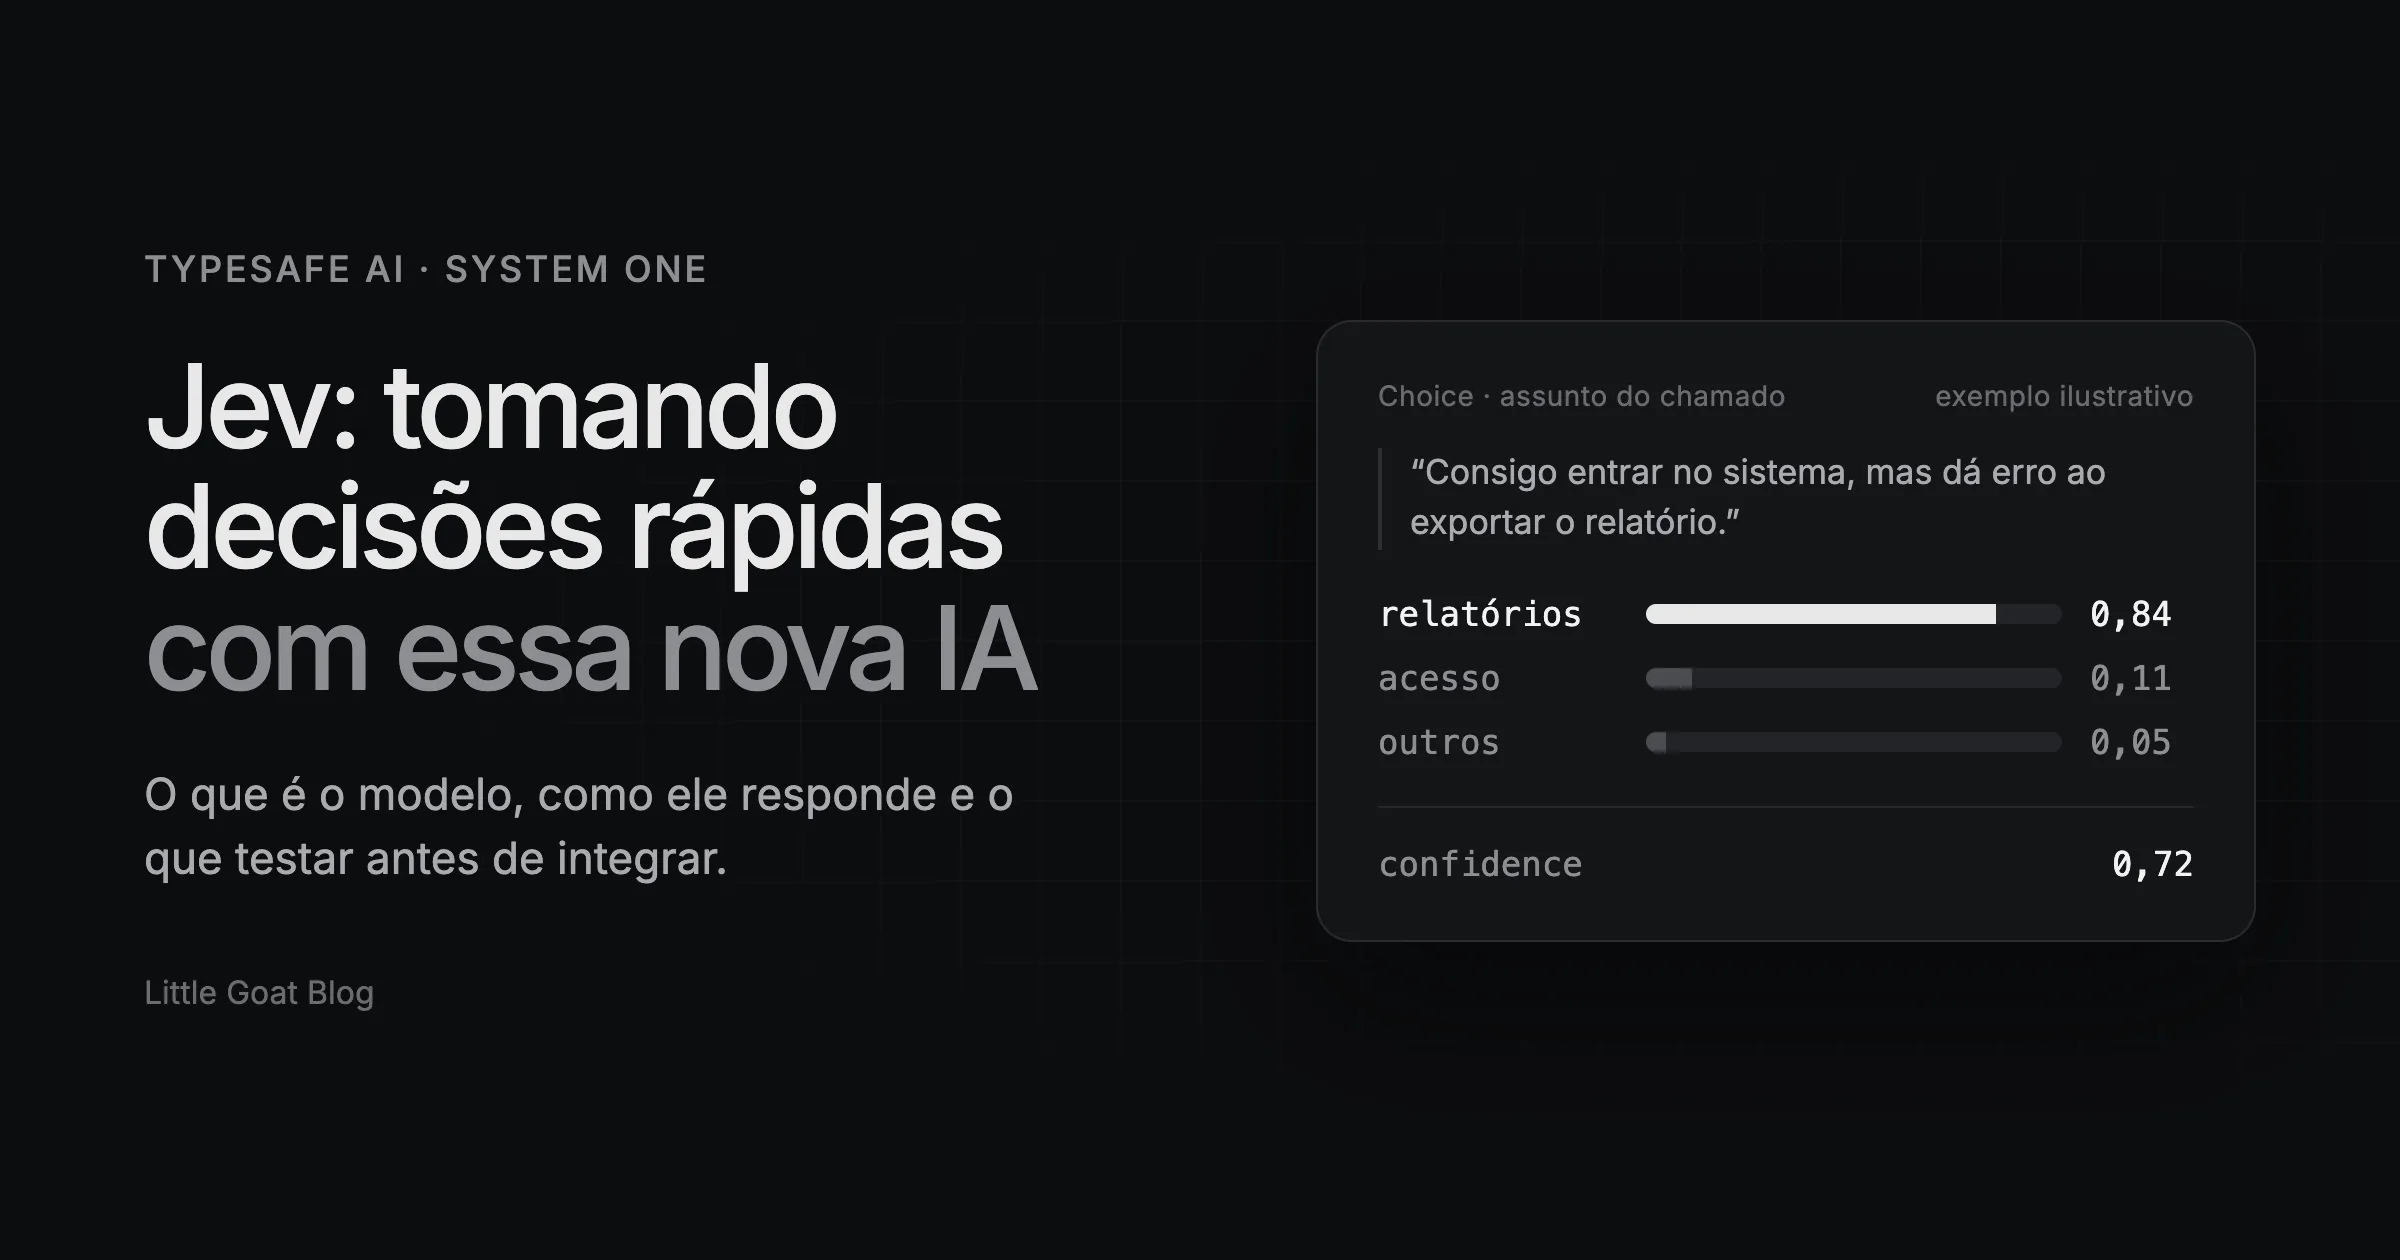
Considere este cenário fictício: um cliente escreve que consegue entrar no sistema, mas recebe um erro ao exportar um relatório. A aplicação trabalha com as categorias “acesso”, “relatórios” e “outros”.
O fluxo fica assim:
- A aplicação envia a mensagem e a definição de cada categoria.
- Uma pergunta Choice pede a categoria do assunto.
- O código confere se a resposta atende ao critério de aceitação definido pela equipe.
- O chamado vai para a equipe escolhida ou para uma fila de revisão humana.
Classificar a mensagem como “relatórios” não corrige o erro nem dá permissão para mexer na conta do cliente. O modelo entrega uma classificação, e as permissões e ações continuam sob responsabilidade da aplicação. Com essa separação, fica mais fácil descobrir em que ponto uma automação errou.
Confiança não é porcentagem de acerto
Nas respostas Choice e Score, o campo probabilities traz a distribuição entre as alternativas ou os níveis. O campo confidence resume essa distribuição num número de 0 a 1: probabilidade concentrada numa opção indica uma resposta confiante, e probabilidade espalhada indica incerteza. As respostas Noul não têm esse campo. Fonte: documentação de confiança.
Por isso, confidence: 0.9 não quer dizer “90% de chance de estar certo”. A própria documentação diz que o limiar certo depende do domínio e do desempenho do modelo em cada caso, então ele precisa ser medido no seu conjunto de exemplos. Um limiar que basta para organizar chamados pode ser baixo demais para uma ação com consequência maior.
No exemplo do suporte, separe as mensagens claras das ambíguas e conte quantos encaminhamentos a equipe precisou corrigir. Olhe com atenção os casos que o sistema aceitou com confiança alta e classificou errado, porque são eles que passam sem revisão.
O Jev não alucina?
No anúncio, a TypeSafe liga essa promessa à garantia de que a resposta sempre segue o esquema definido. A afirmação pede leitura cuidadosa, porque uma categoria permitida ainda pode ser a categoria errada. Respeitar o formato não prova que o modelo entendeu o contexto. Fonte: seção sobre alucinação e tipos.
Se “financeiro” e “suporte” são opções válidas, escolher “financeiro” para um problema técnico cumpre o contrato de dados e falha no atendimento. A validação precisa cobrir as duas coisas.
Quanto o Jev é mais rápido e mais barato?
A TypeSafe divulga ganhos de 193,6 vezes em velocidade e 444,6 vezes em custo nas avaliações de workflows que ela mesma conduziu. O anúncio diz que espera que esses números fiquem na faixa superior dos ganhos reais e informa que as respostas de outros modelos de ponta serviram de referência. São números do fornecedor, não medições independentes, e não garantem o mesmo resultado em outra aplicação. Fonte: metodologia e ressalvas.
Para comparar alternativas, meça o fluxo inteiro: chamadas, novas tentativas, tempo de espera e revisão manual. Uma resposta rápida perde boa parte do valor se manda trabalho para a equipe errada.
Como começar a testar o Jev
O guia oficial de início rápido apresenta o Playground e a API. No Playground, você informa um contexto e acrescenta perguntas; a API leva o mesmo processo para dentro do software. O acesso depende da liberação da sua conta.
Para um primeiro teste, escolha uma decisão pequena e reversível. Monte exemplos reais em português, inclua casos ambíguos e defina antes o que conta como erro. Compare os resultados com a regra ou a ferramenta que você usa hoje e mantenha a revisão humana durante toda a avaliação.
A pergunta prática é: qual decisão repetida está travando um fluxo do seu sistema? Se ainda não há um recorte claro, nosso guia sobre manter, integrar ou reescrever um sistema ajuda a organizar essa análise antes de escolher a tecnologia.
Vamos conversar sobre seu projeto.
Conte o que você precisa, o que já tem e o que gostaria de mudar.
Fale com a Little Goat